레딧 댓글 스크래퍼: 레딧 스레드를 CSV 또는 JSON으로 내보내기
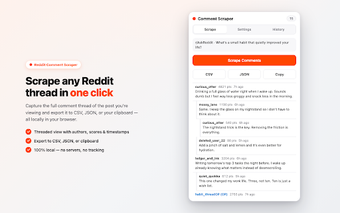
레딧 댓글 스크래퍼 - CSV 및 JSON 내보내기, 개발자로부터, 연구자 및 분석가를 위해 레딧 토론을 추출합니다. 사용자가 단일 작업으로 전체 댓글 트리를 구조화된 CSV 또는 JSON 파일로 저장할 수 있게 하여 정성적 및 정량적 워크플로우를 목표로 합니다. 이 도구는 연구, 저널리즘 및 마케팅 팀이 하류 분석 및 보고를 위해 레딧 대화에 신속하게 접근할 수 있도록 간단한 캡처 및 내보내기를 강조합니다.
스크레이퍼는 무엇을 수집하도록 구축되었으며, 누가 가장 많은 혜택을 받습니까?
이 확장은 개별 Reddit 게시물에서 댓글 스레드를 수확하는 데 중점을 두며, 분석을 위해 대화 데이터를 필요로 하는 시장 조사원, 데이터 과학자, 기자 및 학생들에게 적합합니다. 단일 스레드 추출을 지원하며, 논의 내용을 표준 분석 파이프라인으로 이동하는 것을 명시적으로 목표로 합니다. 사용 사례에는 감정 연구, 고객 피드백 집계 및 학술 연구가 포함되며, 대화의 맥락을 보존하는 것이 중요합니다.
클라우드 도구와 비교하여 개인 정보 보호 및 데이터 흐름을 어떻게 처리합니까?
이 확장은 스크랩된 데이터를 브라우저 내에서 완전히 처리하며, 콘텐츠를 개발자 서버로 전송하지 않으므로 클라우드 업로드 요구 사항과 외부 계정을 제거합니다. API 키 없이 Reddit의 공개 엔드포인트에 접근하며, 개발자와 연결된 원격 저장소를 피합니다. 이러한 설계는 데이터를 사용자의 기계에 유지하고 추출 단계에서 제3자 인프라에 대한 의존도를 줄입니다.
비 프로그래머에게 접근 가능하며 연구 워크플로우에 대해 반복 가능합니까?
팝업 기반의 코드 없는 인터페이스는 사용자가 포함할 필드를 선택하고 로컬 기록에서 이전 세션을 다시 열 수 있게 하여 스크립팅 없이 반복 작업을 쉽게 만듭니다. 사용자는 저자, 점수, 타임스탬프 및 본문 텍스트와 같은 메타데이터를 선택할 수 있습니다. 이 확장은 내보낸 파일에서 답글 중첩을 보존하므로 스레드 구조와 메타데이터가 스프레드시트 및 프로그래밍 분석 모두에 사용할 수 있습니다.
어떻게 확장되며 사용자가 기대해야 할 실제 한계는 무엇입니까?
대량 내보내기는 여러 개의 열린 Reddit 탭에서 댓글을 하나의 파일로 결합할 수 있으며, 이는 배치 수집 속도를 높이지만 처리 부하를 브라우저로 전환합니다. 모든 처리가 로컬에서 실행되므로 리소스 수요는 열린 탭 수와 스레드 크기에 따라 달라지며, 매우 큰 배치는 브라우저를 느리게 할 수 있습니다. 이 확장은 Chrome 및 기타 Chromium 기반 브라우저에서 사용할 수 있으므로 대량 내보내기 중 리소스를 관리하기 위해 전용 프로필에서 테스트하는 것이 좋습니다.
지역적이고 반복 가능한 Reddit 데이터 수집을 위한 집중 도구
이 확장 프로그램은 외부 계정 없이 Reddit 대화에 직접 접근해야 하는 연구자와 분석가에게 실용적인 선택입니다. 거래가 예상됩니다: 로컬 처리는 브라우저에서 계산을 수행하므로 적당한 배치로 수집을 계획하십시오. 팁: 전용 브라우저 프로필을 사용하고 결과 CSV 또는 JSON을 선호하는 분석 환경으로 가져와 워크플로를 깔끔하고 재현 가능하게 유지하십시오.